|
思聪网 TechGG.com讯 11月2日,美团龙猫团队发布"国模国芯“的原生多模态模型 LongCat-2.5,总参数量达到1.6万亿,每个 Token 激活约480亿参数。新模型在 LongCat-2.0 基础上强化视觉理解与智能体编程能力,重点面向复杂代码库开发、完整项目构建等需要连续执行多个步骤的任务。 这次升级的重点落在任务执行的连续性上。对于编程智能体而言,生成一段代码只是工程任务的一部分。它还需要理解已有项目、修改文件、运行测试,并根据执行结果继续调整。任务链条越长,前一步的遗漏就越可能影响后续操作,模型需要在多轮执行中持续掌握任务状态。 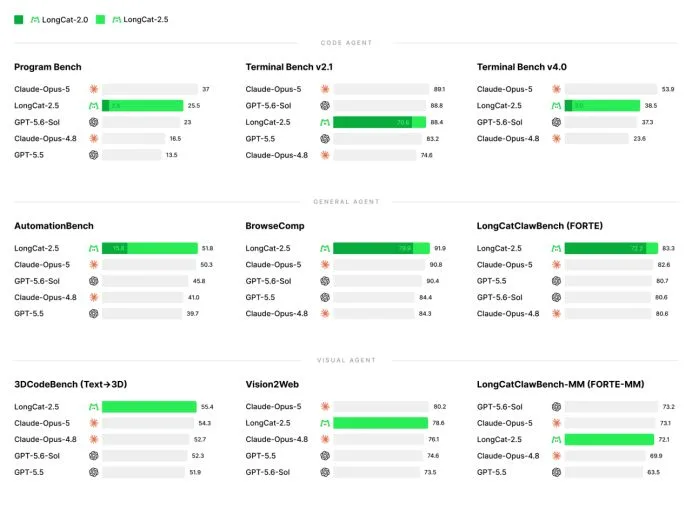 龙猫团队披露,LongCat-2.5 在长序列训练中加入了更多长程任务轨迹,并采用大规模长程强化学习,提升端到端工程能力。团队还将真实智能体的失败过程转化为可复现、可验证的训练任务,针对暴露出的能力短板补充训练数据。这意味着,智能体在执行中如何出错、如何修正,也被纳入模型训练过程。 视觉能力则为这条执行链增加了另一类输入。按照官方介绍,LongCat-2.5 将视觉信号表示为多层级离散 Token,让主干模型以统一形式处理视觉与文本。对于根据界面图片编写网页等任务,理解画面与生成代码需要紧密衔接;此次升级将这两项能力放在同一个模型中强化。 1.6万亿的参数规模也需要结合激活量理解。LongCat-2.5 采用混合专家架构,每个 Token 激活的参数约占总量的3%。总参数反映模型整体规模,激活参数则描述单次计算涉及的部分,两者不能直接换算成实际响应速度或使用成本。 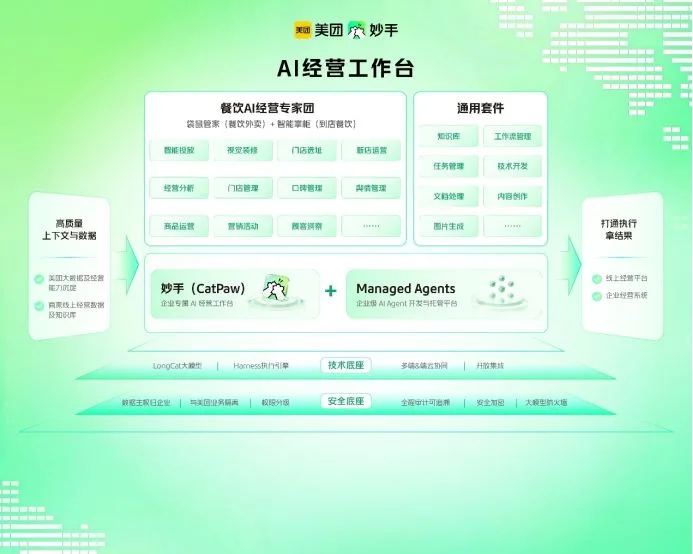 从此次公布的训练方向看,美团正在把更多投入放到模型完成整项任务的能力上。对长程智能体而言,视觉理解、代码生成和工具调用最终要在同一条工作流程中配合。LongCat-2.5 能否持续处理执行中的错误、减少人工接管,将是评估其实际用途的重要尺度。 目前,官方已提供在线体验和 API 接入入口;技术博客中的 GitHub 与 Hugging Face 链接仍标注为即将上线,模型权重的开放状态需以后续公告为准。 |
© 2017-2026 思聪网 · TechGG.com 保留所有权利 基于 Discuz X8.8 设计 京ICP备14029665号-4


最新评论0