|
思聪网 TechGG.com消息,微软AI于10月15日披露,已完成基础模型MAI-Base-2的预训练。该模型采用混合专家架构,总参数2.8万亿,每次激活约800亿参数。 微软同时介绍了训练效率和内部评估结果,强调掌握从数据到训练的完整开发流程。这是一项基础模型研发进展,尚不能等同于同名消费产品已经发布。 基础模型处于AI产品链条的上游。预训练为模型建立广泛的知识和模式识别能力,后续还需通过指令训练、强化学习、工具适配和安全评估,形成面向具体用户的系统。 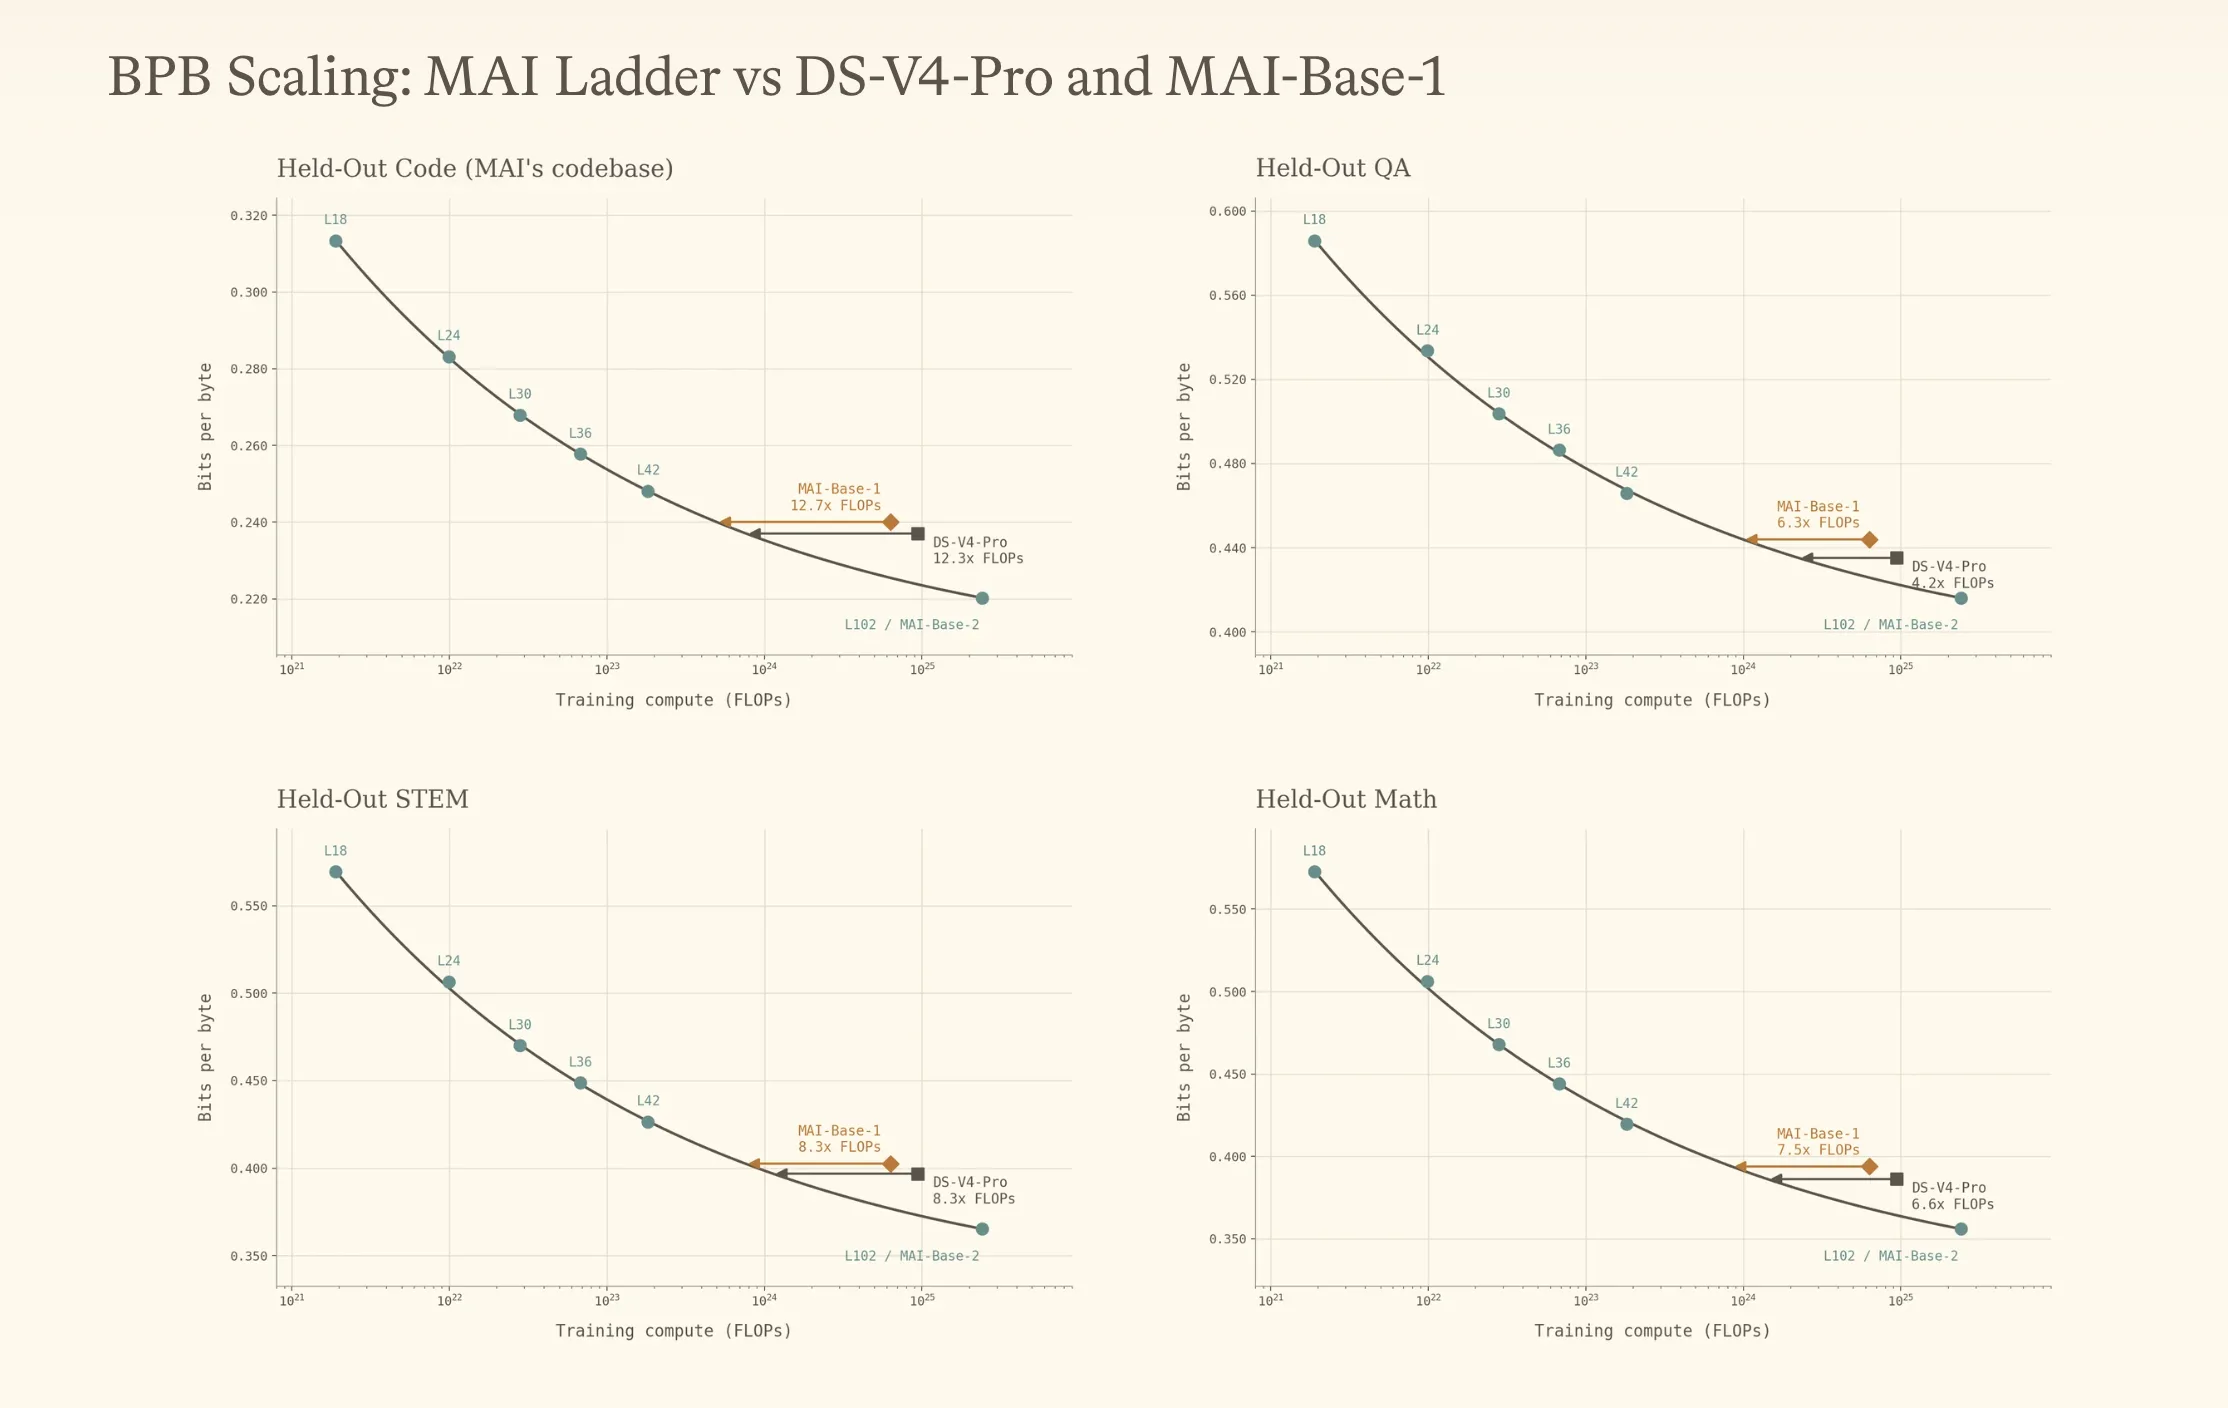 因此,MAI-Base-2的意义首先在研发能力。微软可以围绕自有模型继续开发不同用途的产品,并在训练数据、能力取舍和更新节奏上拥有更多选择。 混合专家架构是支撑这一规模的重要技术。模型并非每次计算都调用全部参数,而是选择部分网络处理输入,从而在扩大总容量的同时控制单次计算量。但完整权重仍需存储和调度,模型规模也会对训练通信、推理部署与维护提出要求。 微软强调的预训练效率,需要放到技术条件中比较。更少的计算量取得更好的内部评估结果,可能意味着训练方法有所改善;它并不直接说明最终产品一定更便宜,也无法单独证明用户任务上的表现。 从产业角度看,大型软件公司自研模型正在成为持续投入。拥有应用入口的企业,可以用产品需求指导模型训练,也有机会在成本、延迟和专业能力之间作出针对性选择。 这种优势仍需要经过产品验证。未来值得观察的,是MAI-Base-2将产生哪些后训练版本、如何开放,以及其能力能否在独立测试中复现。对用户而言,参数规模只提供背景,真正有意义的仍是任务完成质量、使用成本和稳定性。 微软博客 原文 https://microsoft.ai/news/frontier-pre-training-at-microsoft-ai/ |
© 2017-2026 思聪网 · TechGG.com 保留所有权利 基于 Discuz X8.8 设计 京ICP备14029665号-4


最新评论0