|
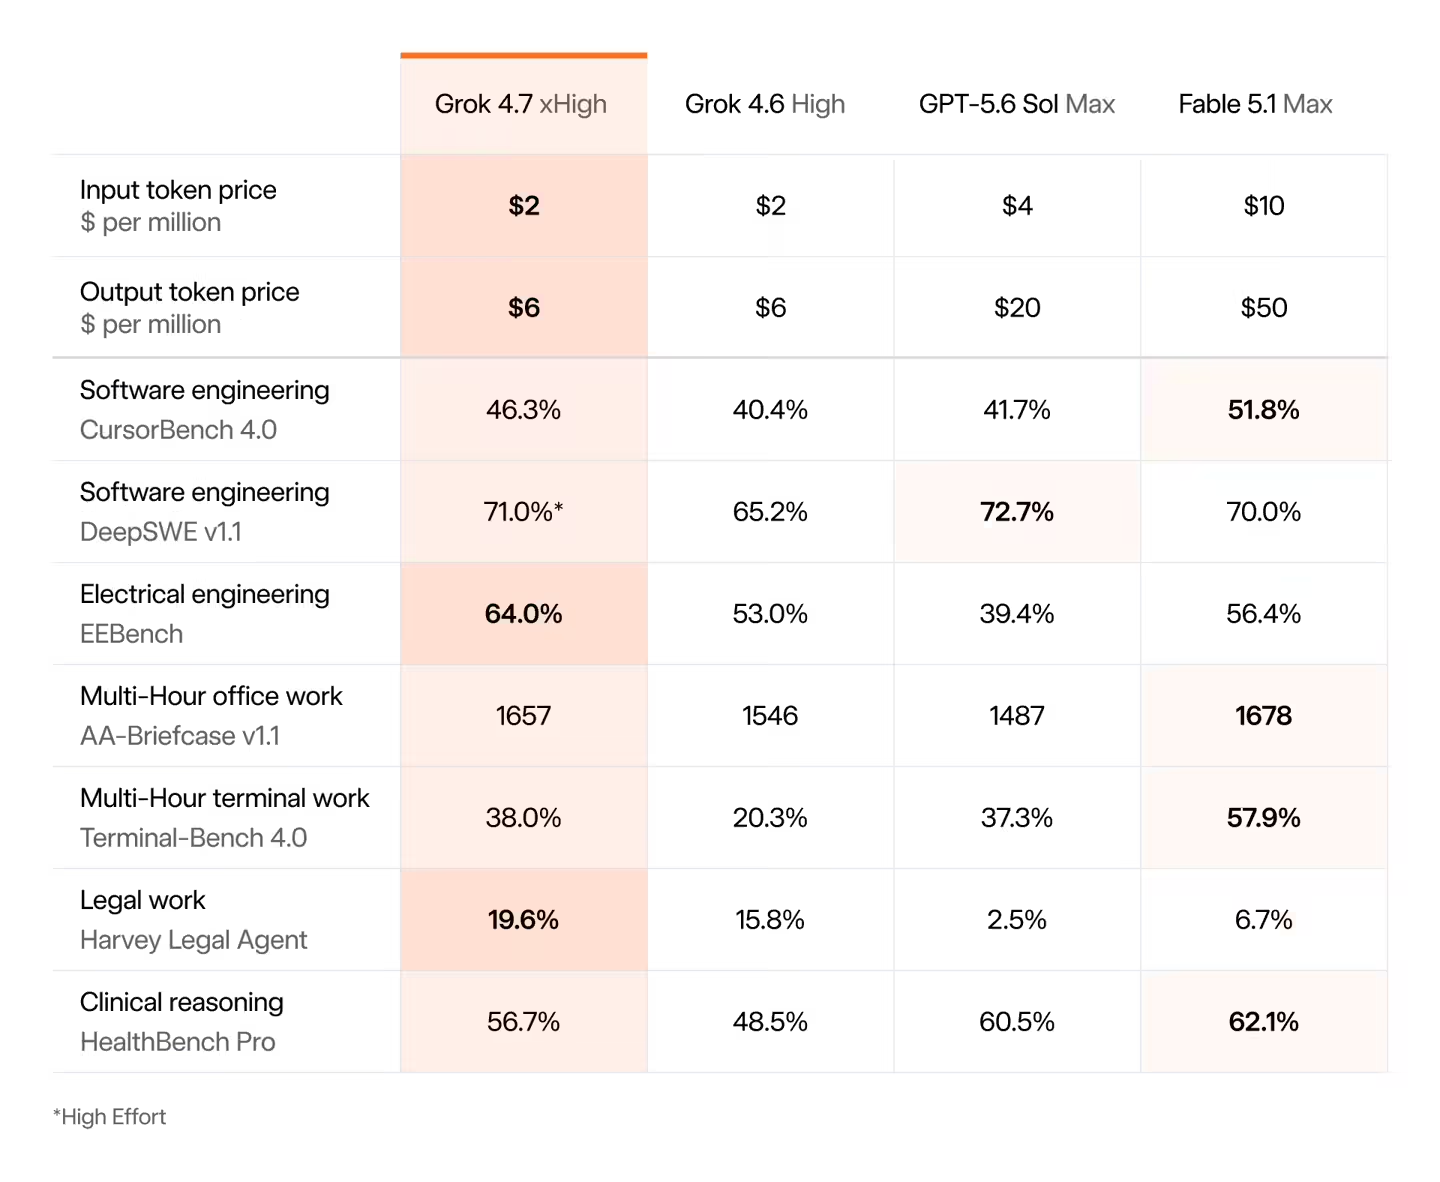
又一个大模型开始把竞争重点从“回答得更聪明”,转向“能不能把一件复杂工作真正做完”。 9月22日,马斯克旗下AI公司 SpaceXAI 正式发布新一代模型 Grok 4.7,重点瞄准编程、知识工作以及需要长时间持续执行的复杂任务。 SpaceXAI称,Grok 4.7采用了规模更大的基础模型,并进行了更长时间的强化学习训练,目前是公司最强的编码和知识处理模型。 价格则延续了上一代的低价策略:输入每百万Token 2美元,输出每百万Token 6美元。 按照官方说法,Grok 4.7在速度、价格和性能之间进行了重新平衡,并针对长时间编程任务进行了专门优化。
不只是“更大的模型”,而是让AI干活更久与上一代Grok 4.6相比,Grok 4.7最明显的变化并不是简单增加模型参数,而是训练方式发生了变化。 SpaceXAI表示,新模型使用了更大的基础模型,同时接受了更长时间的强化学习训练。 训练数据也更加侧重那些需要数小时才能完成的复杂任务。 这其实对应着AI应用正在发生的一种变化。 早期的大模型主要解决的是“问一个问题,给一个答案”。 而现在的AI Agent和编程助手,需要处理的往往是一项完整工作: 分析需求、阅读代码、修改文件、运行测试、发现错误,再重新修改,最后提交结果。 这种任务最大的难点并不是某一个瞬间的推理能力,而是能否持续保持上下文,并在发现错误之后自己纠正。 SpaceXAI因此特别加强了Grok 4.7的自我验证和长上下文管理能力。 简单来说,就是让模型少一点“答完就算”,多一点“做完再检查”。 专门为编程Agent训练Grok 4.7此次还针对 Grok Bot harness 进行了原生训练。 这意味着SpaceXAI并不是只把模型本身训练得更强,而是开始围绕“模型+工具+执行环境”进行整体优化。 对于编程场景而言,这一点尤其重要。 一个真正的AI程序员并不是只需要生成几段代码,而需要不断与开发环境交互。 例如: 读取代码 → 理解项目 → 修改代码 → 执行测试 → 分析报错 → 再次修改 → 验证结果。 因此,模型是否适合Agent运行环境,已经成为衡量编码模型的重要指标。 SpaceXAI表示,Grok 4.7在CursorBench 4.0测试中针对长时间运行的编程任务表现突出。 与此同时,Grok 4.7已经通过 Cursor、Grok Build 提供,并开放Grok API,可以接入第三方编程工具、模型路由服务和云平台。 这也意味着它不只是面向Grok聊天产品的模型,而是在直接争夺开发者的AI编程入口。 从写代码,到做“知识工作”Grok 4.7的目标也没有停留在程序员群体。 SpaceXAI同时强化了模型在文档、演示文稿以及一般知识工作中的能力。 在GDPval和AA Briefcase两项测试中,Grok 4.7相比Grok 4.6均有所提升。 这两类测试的共同特点,是要求AI完成更加接近真实职业工作的任务,例如律师、护士、金融分析师等专业人士日常会处理的工作。 这背后其实透露出大模型竞争的一个重要方向: AI公司的竞争对象正在从“聊天机器人”变成“数字员工”。 如果模型只能回答问题,那么参数规模和知识准确率可能是核心指标。 但如果模型开始承担实际工作,评价标准就会变成另外一套东西—— 能不能理解任务? 能不能连续工作? 能不能调用工具? 能不能发现自己的错误? 能不能最终交付一个可以使用的结果? Grok 4.7显然正在沿着这条路线走。 价格没有涨,输入2美元、输出6美元Grok 4.7另一个值得关注的地方,是价格。 SpaceXAI给出的API价格为:
按照目前汇率计算,输入成本约为每百万Token 13.4元人民币,输出约40.2元人民币。 SpaceXAI甚至宣称,相比同类模型,Grok 4.7能够做到“速度更快、价格更低”。 不过,这类横向比较需要结合具体模型、Token计算方式以及实际任务负载来看,单纯比较API单价并不能完全反映实际使用成本。 对于Agent而言,真正重要的还包括一次任务到底需要调用多少次模型,以及模型是否能够减少反复尝试的次数。 便宜的模型,如果需要调用十次,未必比贵一点但一次完成的模型更省钱。 这也是Grok 4.7把“长时间任务能力”放在重要位置的原因之一。 安全也成为新模型的一部分随着模型开始执行代码、网络安全研究甚至生物相关任务,AI安全已经很难再只是一个简单的“敏感词过滤器”。 SpaceXAI表示,Grok 4.7采用了新的安全防护体系,在拒答和抵抗越狱攻击方面达到公司目前测试中的最高水平。 在双重用途领域,SpaceXAI尤其强调“既不能什么都拒绝,也不能什么都放行”。 例如网络安全领域,合法的安全研究、漏洞验证和红队工作本身具有实际价值,但同样的技术也可能被用于攻击。 SpaceXAI公布的HackerBench v0.3测试显示,Grok 4.7仅有3.3%的高风险双重用途提示通过,同时尽量减少对合法安全工作的阻止。 在生物安全测试中,Grok 4.7在LatchBio基准上获得62.4%的成绩。 此外,SpaceXAI已经开始向部分网络安全合作伙伴提供邀请制访问,用于红队能力和防御研究。 Grok的竞争逻辑正在发生变化从Grok 4到Grok 4.7,SpaceXAI正在逐渐改变自己的模型竞争方式。 过去,大模型之间更多是比较: 参数规模、知识能力、数学推理、代码能力和Benchmark成绩。 但到了Agent时代,单项Benchmark的重要性正在下降。 一个模型即使某个考试分数很高,如果让它连续工作几个小时就开始遗忘上下文、重复犯错,实际价值仍然有限。 因此,Grok 4.7此次反复强调的其实是三个关键词: 长时间任务、工具调用、自我验证。 这三项能力组合起来,指向的已经不是传统意义上的聊天机器人,而是能够持续执行任务的AI Agent。 从这个角度看,Grok 4.7真正值得关注的并不是“4.7”这个数字,而是SpaceXAI正在尝试把模型竞争从**“谁回答得更好”推进到“谁能把事情做完”**。 而这场竞争,接下来很可能会从模型公司进一步蔓延到Cursor、云平台、AI编程工具以及整个Agent基础设施市场。 |
© 2017-2026 思聪网 · TechGG.com 保留所有权利 基于 Discuz X8.8 设计 京ICP备14029665号-4

最新评论0