文/涛涛「思聪网」
AI芯片市场正在从“比算力”转向“比推理效率和系统规模”。
9月21日,韩国AI芯片初创企业 FuriosaAI 公布第三代AI推理加速器的技术细节。该产品由FuriosaAI与博通(Broadcom)合作开发,采用2nm计算裸晶与HBM4内存,并通过机架级互联设计面向下一代大模型和Agentic AI推理。
从纸面规格来看,这款新芯片相比FuriosaAI上一代RNGD出现了大幅跃升:算力最高达到32 PFLOPS,HBM内存容量576GB,内存带宽48TB/s。
其中,算力和内存带宽均达到上一代产品的32倍。
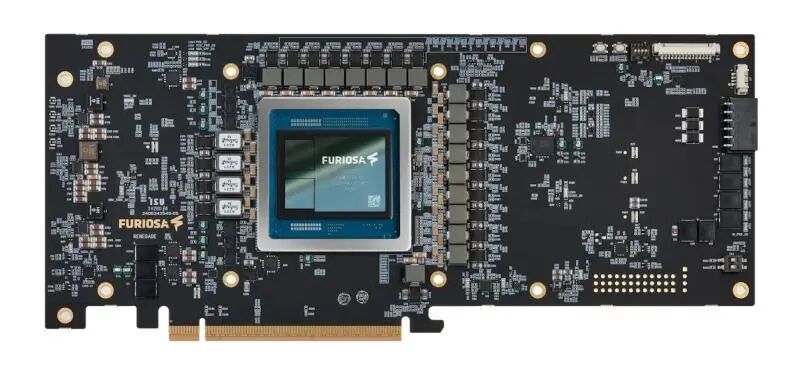
两颗2nm计算裸晶,搭配12组HBM4
根据FuriosaAI公布的信息,这款第三代推理加速器采用了较为激进的Chiplet设计。
整颗加速器包含2颗2nm计算裸晶、1颗独立I/O裸晶,以及12个48GB HBM4(E)内存堆栈。按照公布规格计算,HBM4总容量达到576GB。
在互联方面,新平台采用机架级SUE全连接拓扑,同时支持PCIe Gen7。
FuriosaAI表示,新产品物理尺寸约为第二代RNGD的8倍,但由此带来的计算和内存能力提升更加明显。
核心规格包括:
指标 | 第三代加速器 | 第二代RNGD |
|---|---|---|
算力 | 32 PFLOPS | 最高约1 PFLOPS级 |
HBM容量 | 576GB | 48GB |
HBM带宽 | 48TB/s | 1.5TB/s |
制程 | 2nm | 台积电5nm |
PCIe | Gen7 | Gen5 |
HBM | HBM4(E) | HBM3 |
FuriosaAI官方资料显示,第二代RNGD采用台积电5nm工艺,集成48GB HBM3,内存带宽为1.5TB/s,FP8算力512 TFLOPS、INT4算力1024 TOPS。(Furiosa Developer Center)
因此,第三代产品的变化并不是简单地“把上一代芯片做大”。
计算单元、内存系统和芯片间互联都在同步升级。
为什么FuriosaAI突然需要这么大的内存带宽?
这与AI计算的变化有关。
过去,大模型推理更多关注单颗GPU能够提供多少计算能力;但随着模型参数规模增长,以及长上下文、推理模型和AI Agent逐渐普及,内存容量和数据搬运速度正在成为推理系统的重要瓶颈。
尤其是Agentic AI。
一个Agent完成任务,可能需要连续调用模型几十次甚至更多次。模型不仅要进行计算,还需要不断读取KV Cache、上下文以及中间状态。
因此,AI推理已经不再只是“算得快”。
更重要的是:
模型能不能装得下、数据能不能喂得上、多个加速器之间能不能快速交换数据。
FuriosaAI此前与博通宣布合作时也强调,面向Agentic AI的推理系统需要同时解决计算、内存和Scale-up扩展问题。(FuriosaAI)
这也是为什么新产品把HBM带宽直接拉到了48TB/s。
相比上一代RNGD的1.5TB/s,这是整整32倍。
从单卡NPU走向“机架级推理平台”
更值得注意的其实不是32 PFLOPS,而是FuriosaAI开始改变产品的形态。
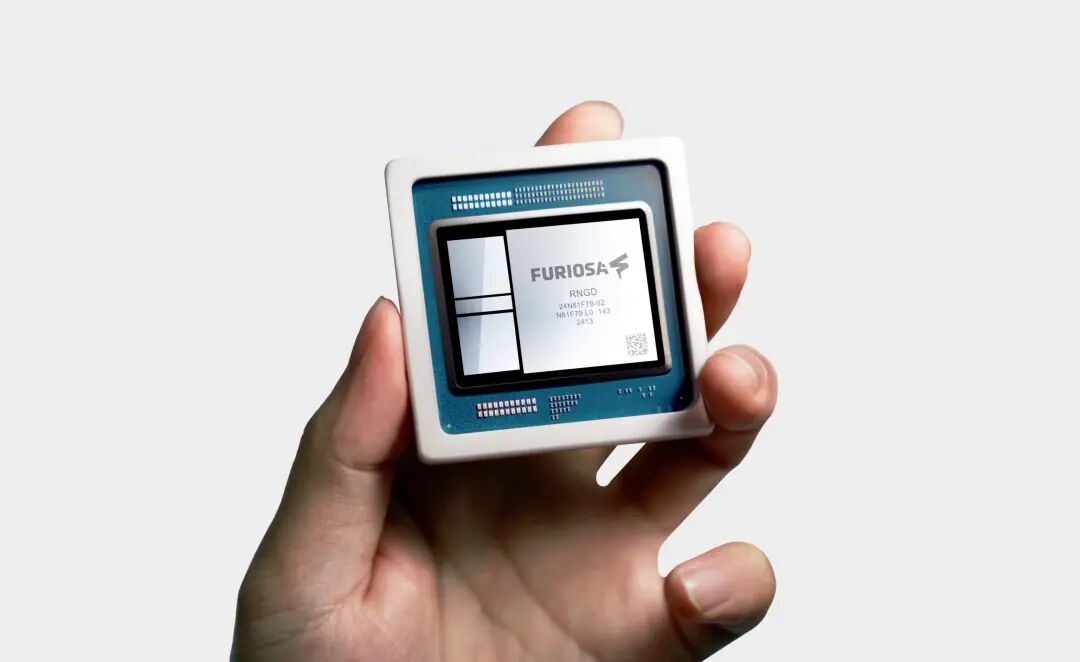
上一代RNGD本质上还是一张数据中心AI加速卡。
它采用PCIe接口,可以安装在服务器中,单卡提供256 TFLOPS BF16、512 TFLOPS FP8以及1.5TB/s HBM3带宽。(Furiosa Developer Center)
到了第三代产品,FuriosaAI已经开始围绕机架级系统设计。
两颗计算裸晶、独立I/O裸晶、12组HBM4以及机架级全连接拓扑,说明其目标已经不再是一张孤立的AI加速卡,而是让大量计算资源形成一个更紧密的推理系统。
这条路线其实与整个AI基础设施行业的变化高度一致。
当模型越来越大之后,单颗芯片已经很难独立承担全部计算任务。
于是,AI芯片厂商竞争的重点开始从:
“我的芯片有多少TFLOPS?”
逐渐变成:
“我的芯片能不能高效地连接起来?”
韩国AI芯片开始挑战英伟达之外的市场
FuriosaAI并不是一家刚刚出现的AI芯片公司。
这家公司成立于2017年,长期专注于AI推理加速器,其核心架构是自研的Tensor Contraction Processor(TCP),目标是针对深度学习中的张量收缩操作进行硬件优化。
第二代RNGD已经进入量产,并被用于LLM、多模态模型和视觉模型推理。FuriosaAI今年还与三星SDS合作推出韩国本土NPU云服务。(FuriosaAI)
与此同时,FuriosaAI正在推进海外市场。
今年9月,公司宣布在新加坡设立区域中心,推动亚太市场扩张;此前也已经在欧洲葡萄牙以及美国湾区建立业务布局。(FuriosaAI)
这说明FuriosaAI的目标已经不是单纯成为一家韩国本土AI芯片公司。
它试图进入的是全球数据中心推理基础设施市场。
“GPU之外”,正在成为AI芯片的新战场
过去几年,AI芯片市场几乎围绕GPU展开。
但随着生成式AI从聊天机器人进入搜索、编程、视频、企业应用和Agent,AI计算的重心正在从训练逐步向推理扩展。
训练阶段追求的是极限算力和大规模集群,而推理阶段更加复杂。
不同客户需要不同的延迟、吞吐、成本和能耗组合。
FuriosaAI过去一直强调的正是这一点:AI推理并不只是追求峰值算力,而需要同时考虑性能、可编程性和功耗。
目前FuriosaAI第二代RNGD已经针对LLM和Agentic AI进行优化,公司公布的资料显示,其重点之一就是在数据中心有限的功率预算下提升单位机架的推理服务能力。(FuriosaAI)
因此,第三代产品把重点放到HBM4、超高带宽以及机架级互联上,也就不难理解了。
,可能不只是“谁的芯片算得更快”,而是“谁能以更低的系统成本,把更多Token送到更多用户面前”。
当然,目前FuriosaAI公布的32 PFLOPS等数据属于芯片规格层面的理论指标,具体采用何种精度、实际模型吞吐、功耗以及与主流GPU在真实工作负载下的表现,仍需要等待后续产品和基准测试验证。
但至少从技术路线来看,这家韩国AI芯片公司已经把目标从“做一张更快的NPU”,进一步推向了面向大模型和Agent时代的下一代推理基础设施。